C++ × CPU マイクロアーキテクチャ で見るメモリアクセス性能はじめに
「同じメモリを何度も読むだけなんだから、速いはずだろう」
最初にこのベンチマーク を書いたとき、自分もそう思っていました。C++ で計測してみると、同じアドレスを延々と Read/Write するコードが、アドレスを毎回変えるコードよりも桁違いに遅い 、という直感に反した結果が出ます。
この挙動は「キャッシュに乗る / 乗らない」といった単純な話ではありません。
Store Buffer(ストアバッファ)
Load Queue(ロードキュー)
Store-to-Load Forwarding(ストア→ロード転送)
Out-of-Order Execution(アウト・オブ・オーダ実行)
といったマイクロアーキテクチャ 機構が、メモリアクセスの「アドレスの性質」に強く反応している結果です。
この記事では、以下を狙いどころにします。
C++ による小さなベンチマーク で「同一アドレス vs 異なるアドレス」を実測するCPU マイクロアーキテクチャ の観点から、それぞれで何が起きているのかを整理する
実際のコード最適化で何に気をつけると効くのか、ヒントをまとめる
最後に、理解を深めるための日本語の書籍をいくつか紹介する
1. 2つのアクセスパターン
今回扱うのは、あえて極端に単純化 した2パターンです。
同一アドレスへ連続アクセス
例:同じ int value; に対して value += 1; をひたすら繰り返す
Load と Store が常に同じアドレスを指す
異なるアドレスへ順次アクセス
例:array[i] += 1; を i = 0,1,2,... と変えながら実行
Load / Store は毎回別のキャッシュライン上(あるいは少なくとも別のアドレス)を触る
キャッシュに全部乗るサイズであっても、両者の性能差は驚くほど大きくなります。メモリ依存性の処理 の違いから生じます。
2. 計測環境と結果のざっくり概要
2-1. 計測環境(例)
マシン:Intel MacBook Air (x86 _64、2 コア 4 スレッド程度のモバイル向け CPU)
コンパイラ :Clang / Apple Clangビルドオプション:-O3 -march=native
計測方法:rdtsc() によるサイクル数の直接計測
rdtsc による測定は Intel が公開している最適化マニュアルでもよく登場する古典的アプローチで、TSC (Time Stamp Counter)を読み、その差を取る」スタイルです。
2-2. 結果の印象
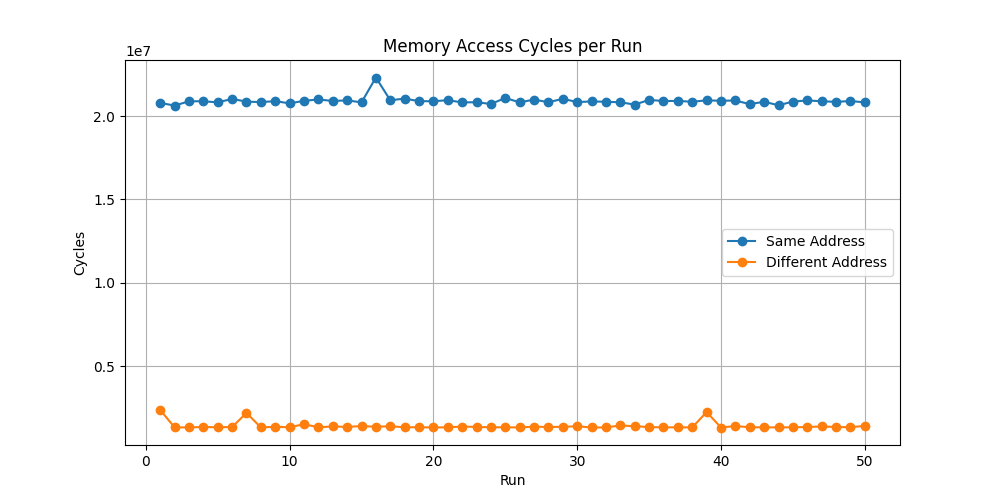
同一条件で 測定したところ、以下のような傾向になりました(あくまで一例です)。
Run毎のメモリアクセス速度
同一アドレスへの Read/Write
1 回あたりの平均サイクル数が 異なるアドレスの 10 倍以上
バラツキも少なく、「ずっと遅い」感じの分布
異なるアドレスへの Read/Write
平均サイクル数はかなり小さく、分布も詰まっている
CPU が内部でうまく並列化してくれている印象
具体的な数値は CPU 世代やコンパイラ によって変わりますが、x86 系 CPU で再現されます。
ここでは、「同一アドレス版」と「異なるアドレス版」の両方を C++ 17 相当で書いた例を示します。
3-1. 同一アドレスに対して加算を繰り返す
#include <cstdint>
#include <cstdio>
#include <x86intrin.h>
constexpr std ::size_t N = 1'000'000 ;
inline std ::uint64_t rdtsc () noexcept {
return __rdtsc ();
}
std ::uint64_t bench_same_address () {
volatile std ::uint64_t value = 0 ;
const auto start = rdtsc ();
for (std ::size_t i = 0 ; i < N; ++i) {
value += 1 ;
}
const auto end = rdtsc ();
return end - start;
}
int main () {
constexpr int trials = 50 ;
for (int t = 0 ; t < trials; ++t) {
const auto cycles = bench_same_address ();
std ::printf ("same, %d , %llu\n " , t, (unsigned long long )cycles);
}
}
ポイントは以下の通りです。
volatile を付けて、コンパイラ 最適化でループごと消されないようにする__rdtsc() を使って TSC を読み取る(GCC /Clang なら <x86intrin.h> で利用可)後で Python から読みやすいように、CSV ライクな形式で出力する
3-2. 異なるアドレスを順番に触る場合
#include <cstdint>
#include <cstdio>
#include <vector>
#include <x86intrin.h>
constexpr std ::size_t N = 1'000'000 ;
inline std ::uint64_t rdtsc () noexcept {
return __rdtsc ();
}
std ::uint64_t bench_diff_address () {
static std ::vector <std ::uint64_t > buf (N, 0 );
volatile std ::uint64_t *p = buf.data ();
const auto start = rdtsc ();
for (std ::size_t i = 0 ; i < N; ++i) {
p[i] += 1 ;
}
const auto end = rdtsc ();
return end - start;
}
int main () {
constexpr int trials = 50 ;
for (int t = 0 ; t < trials; ++t) {
const auto cycles = bench_diff_address ();
std ::printf ("diff, %d , %llu\n " , t, (unsigned long long )cycles);
}
}
buf は L1/L2 キャッシュに十分収まるサイズにしておくと、
3-3. 測定上の落とし穴
マイクロベンチマーク でやりがちな事故も簡単に触れておきます。
最適化でループが消える
ループ展開やベクトル化によって、意図していない命令列になる
rdtsc の前後の命令がリオーダされる(lfence などでシリアライズ するのが定石)電源管理(ターボブースト、周波数スケーリング)でサイクルあたりの実時間が変動する
OS スケジューラで別コアに飛ばされる
本記事では「傾向」を見るのが目的なので、細かいチューニングは省略しますが、Intel の最適化マニュアルや Agner Fog の文書をチェックするのがおすすめです。
アドレス毎のメモリアクセスサイクル 4. CPU マイクロアーキテクチャ のざっくり復習
では、なぜ同一アドレスと異なるアドレスでこんなに差が出るのか。x86 系 CPU のマイクロアーキテクチャ を簡単におさらいします。
4-1. パイプライン+アウト・オブ・オーダ実行
現代の CPU は以下のような流れで命令を処理します。
命令フェッチ・デコード
マイクロオペレーション(uop)への分解
依存関係解析・レジスタ リネーミング
実行ユニット(ALU, Load/Store Unit など)への発行
実行・結果の一時保持
コミット(リオーダバッファからリタイア)
「アウト・オブ・オーダ実行」は、依存関係がない命令同士であれば順番を入れ替えて同時並行に実行する 仕組みです。
4-2. ロード / ストアまわりの構造
メモリアクセスの周辺には、ざっくり以下のような構造があります。
L1 データキャッシュ
数十〜数百サイクルかかるメインメモリよりはるかに速い、1次キャッシュ
ロードバッファ(Load Queue)
飛び出していった Load 命令の情報を溜めておく場所
ストアバッファ(Store Buffer / Store Queue)
Store 命令で書き込む値を、キャッシュに反映するまで一時的に保持しておく場所
Store-to-Load Forwarding
「直前の Store が書いた値を、L1キャッシュではなくストアバッファから直接読み出す」仕組み
ここで重要なのは、ストアバッファとロードキューの間で「アドレスの一致を監視している」 という点です。
直前の Store 群の中に「同じアドレス(あるいは重なるアドレス)」がないかを全部チェックする
あれば、その Store の値を Load にフォワ ードする
条件が合わない/サイズが違う/アライメントがずれているとペナルティが発生し、ロードがリトライになったりパイプラインがストールする
この「アドレスの突き合わせ」が、同一アドレス連打のときに毎回必ず発生する のが本記事の主役になります。
5. 同一アドレス連打が極端に遅くなる理由
さて、value += 1; をひたすら回すループで、CPU 内部では何が起きているのか。
5-1. Store → Load の依存が毎回発生する
以下のような簡略化した命令列を考えます。
load rax , [addr ]
add rax , 1
store [addr ], rax
これを N 回繰り返す場合、各イテレーション の load は 直前の store が書いた値に依存 しています。
CPU は「最新の値は L1 にまだ書き込まれておらず、ストアバッファにあるかもしれない」と判断し、毎回ストアバッファを検索 → 対応するエントリを見つけて値をフォワ ード します。
この処理自体もタダではありません。
ストアバッファは「対応するアドレスがないか」を全エントリに対して(ほぼ)同時に検索する必要がある(CAM 的な構造)
ヒットすると、フォワ ードされたデータが Load の結果となる
条件が合わなかった場合はフォワ ード失敗(ペナルティが乗る)
同一アドレス連打の場合、この依存チェックがループのたびに必ず走り、かつ毎回「依存あり」と判定 されます。
5-2. Out-of-Order 実行が効かなくなる
Out-of-Order 実行は「依存のない命令を前後に動かす」ことで性能を稼ぎます。
load は直前の store と真の依存 を持つ(データ依存)add は load に依存し、store は add に依存する
という「がっちり縦に繋がった」依存チェーンができてしまうため、
CPU 的には、
1 回のループをこなす間、他の似た Load/Store を重ねづらい
依存チェックとフォワ ードを毎回行う必要がある
ストアバッファ・ロードキューのエントリも再利用されにくい
といった事情が積み重なって、見かけ上「1回のメモリアクセスに対するレイテンシ」が大きくなってしまう のです。
6. 異なるアドレスが速い理由
対照的に、array[i] += 1; のように アドレスが毎回異なる 場合を見てみます。
6-1. 依存関係が“縦”から“横”に広がる
アドレスが十分に離れている状況では、
array[i] += 1; と array[i+1] += 1; の間に依存はない各 Load は「直前の Store が書いたアドレス」とは異なる場所を読みに行く
ストアバッファを検索してもヒットしないので、フォワ ードは発生しない(依存なし)
つまり、CPU から見れば「独立した小さなループ本体」がずらっと並んでいるように見えます。
その結果、アウト・オブ・オーダ実行が効き始めます。
先に発行した Load がメモリ待ちの間に、後続の Load もどんどん発行してしまう
Store もストアバッファに溜め込んでおき、キャッシュへの書き戻しを後回しにできる
ロードバッファ・ストアバッファに複数の命令が同時に滞在し、メモリレベル並列性(MLP )が高まる
この「複数のメモリアクセスを同時に飛ばしておいて、どれかが返ってきたらすぐ次を実行する」動きが、平均レイテンシを大幅に隠してくれる わけです。
6-2. キャッシュの局所性も効いてくる
さらに、array[i] を順番に触る場合は
同じキャッシュライン内の要素を連続して読む
ハードウェアプリフェッチャがアクセスパターンを検出し、次のキャッシュラインを先読みする
といった恩恵も受けられます。
このため、「キャッシュに全部乗っているのに速い」ではなく、「キャッシュに全部乗っているからこそ、CPU が全力で並列化できる」 と言う方が正確です。
7. 実測結果のグラフの読み方
50回分のサイクル数を CSV に吐き出し、Python で可視化すると違いは一目瞭然になります。
折れ線グラフ(plot_line.png)
same(同一アドレス)は上の方でベタっと張り付いた線diff(異なるアドレス)はその 1/10 以下の位置で安定
箱ひげ図(plot_box.png)
中央値も最小値も same が diff より桁違いに大きい
外れ値も少なく、「ずっと遅い」ことが分かる
ここで重要なのは、「単に同一アドレスが遅い」ではなく
CPU に“依存あり”と認識されるかどうかで、マイクロアーキテクチャ の動きがガラッと変わる その差が、そのまま計測値の差として現れている
という点です。
8. 実務コードにどう効いてくるか
ここまでの話を、普段書く C++ コードに引き寄せてみます。
8-1. 「同じ場所を叩き続ける」コードに注意
例として、以下のようなコードを考えます。
for (int i = 0 ; i < n; ++i) {
++global_counter;
}
for (int i = 0 ; i < n; ++i) {
lock (mtx);
++counter;
unlock (mtx);
}
どちらも「同じアドレス(counter)を何度も書き換える」典型的なパターンです。
キャッシュラインの競合(false sharing)
Store Buffer の圧迫
Store-to-Load Forwarding まわりの依存
などが重なって、ボトルネック になりやすい
これを避けるために、
スレッドごとにローカルカウンタを持って最後に集計する
ストライド 付きの配列に分散して書き込むstd::atomic でもフェッチ・アンド・アッドを乱用しない
といった「アドレスをバラして書く」設計をすることで、CPU が持つ並列実行能力を活かしやすくなります。
8-2. 構造体のレイアウトと「偽の依存」
構造体やクラスのメンバを更新するときも、同じキャッシュライン内で頻繁に読んだり書いたりするフィールドが固まっていると、
読み取り専用のフィールド
頻繁に更新されるフィールド
を分けて別の構造体にしたり、alignas(64) など)にすることで、
9. 小さな C++ ベンチでマイクロアーキテクチャ を“見る”
まとめとして、本記事のポイントを整理します。
同一アドレスへの連続アクセスが遅い理由
Store Buffer 上のデータを参照するため、Store→Load の依存性チェックが毎回必要
Store-to-Load Forwarding が常に絡み、パイプラインがシリアライズ されやすい
アウト・オブ・オーダ実行で並列化できる余地がほとんどない
異なるアドレスが速い理由
アドレスの依存が薄いため、Load/Store を大量に飛ばしてメモリレベル並列性を稼げる
ハードウェアプリフェッチャやキャッシュ局所性が効きやすく、平均レイテンシを隠せる
C++ でのマイクロベンチ
rdtsc によるサイクル計測で、CPU の内部挙動を「外から」観察できるコンパイラ 最適化や CPU の世代によって数値は変化するが、「傾向」はかなり再現性がある
実務的な示唆
「同じアドレスを叩き続ける」コードは、CPU にとって扱いづらいパターンになりやすい
アクセスパターンを設計する段階で、メモリ依存性と局所性を意識しておくと、後からの最適化コストが下がる
最終的には、
「CPU がどう動いているか」を少しだけ意識しながら C++ のコードを書く
だけでも、パフォーマンスの“地雷”を踏む頻度はかなり減らせます。ベンチマーク はかなりおすすめです。
付録:Python による可視化コード(例)
最後に、C++ 側で吐き出した CSV (pattern,trial,cycles 形式)を可視化する Python スクリプト の例を載せておきます。
import pandas as pd
import matplotlib.pyplot as plt
df = pd.read_csv("result.csv" , header=None , names=["pattern" , "trial" , "cycles" ])
N = 1_000_000
df["cycles_per_op" ] = df["cycles" ] / N
plt.figure()
for pattern, sub in df.groupby("pattern" ):
plt.plot(sub["trial" ], sub["cycles_per_op" ], marker="o" , label=pattern)
plt.xlabel("trial" )
plt.ylabel("cycles per op" )
plt.legend()
plt.grid(True )
plt.tight_layout()
plt.savefig("plot_line.png" , dpi=200 )
plt.figure()
df.boxplot(column="cycles_per_op" , by="pattern" )
plt.ylabel("cycles per op" )
plt.tight_layout()
plt.savefig("plot_box.png" , dpi=200 )
参考文献・参考図書
C++ と性能最適化オンライン資料(英語)
Intel 『Intel 64 and IA-32 Architectures Optimization Reference Manual』Intel 64 / IA-32 向け最適化の公式バイブル。メモリ階層、ロード / ストアユニット、Store Buffer、Store-to-Load Forwarding など、本記事で触れたテーマの詳細な解説がまとまっている。
easyperf.net「Store forwarding by example」x86 の Store-to-Load Forwarding を具体例付きで解説したブログ記事。同一アドレス・サイズ・アライメントの条件や、失敗時のペナルティについて非常に分かりやすい。
これらの書籍・資料をあわせて読むことで、C++ のコード」「CPU マイクロアーキテクチャ 」「実測ベンチ」の三層を行き来しながら、